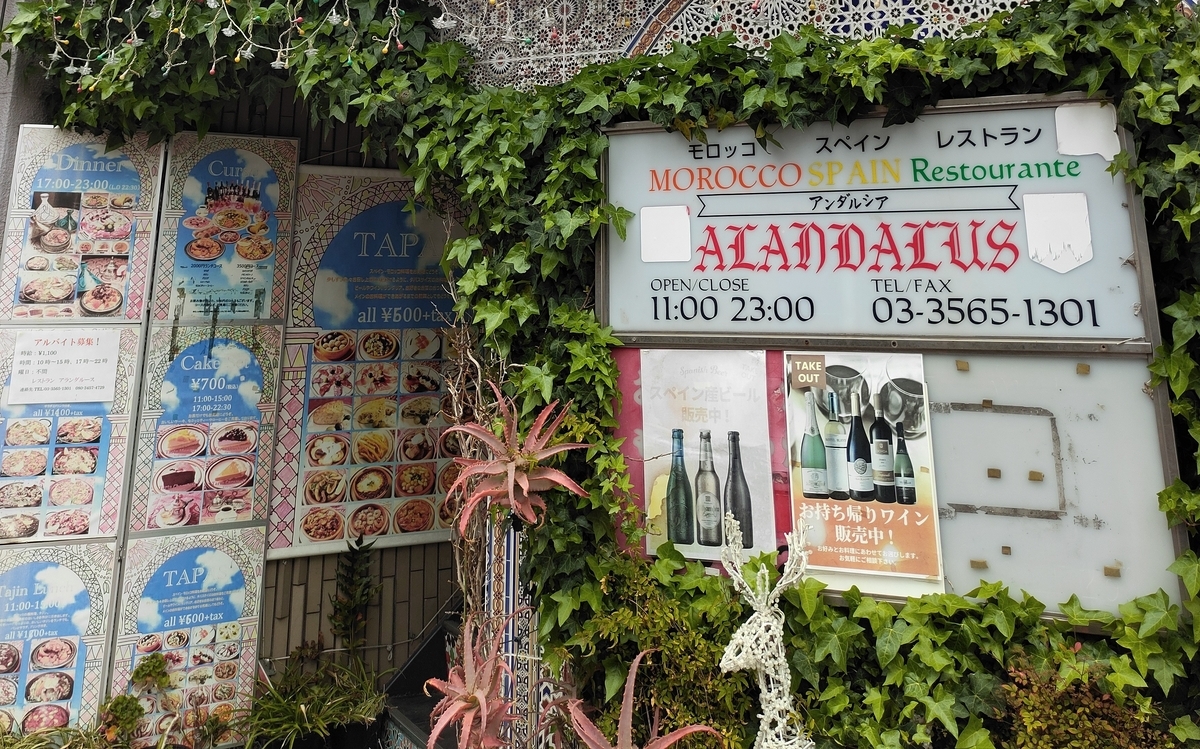
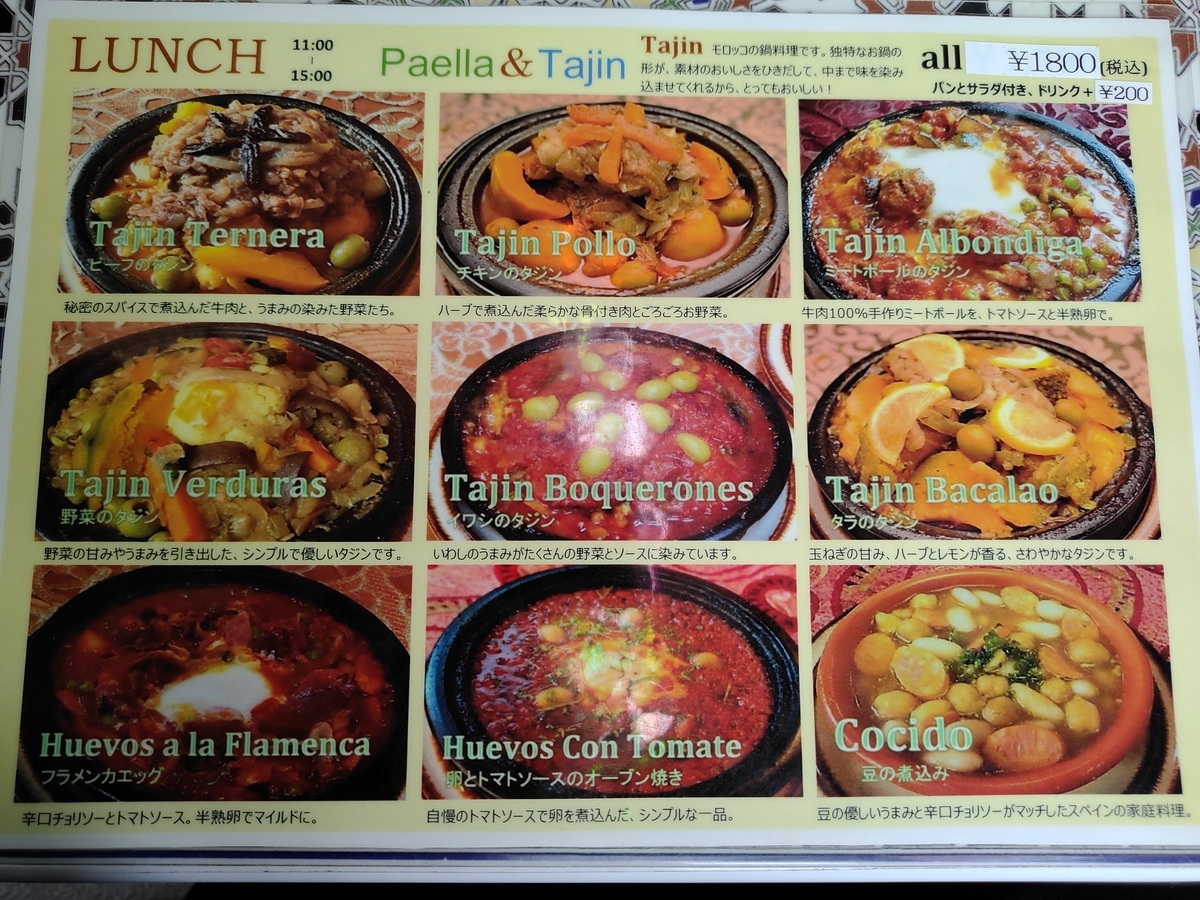
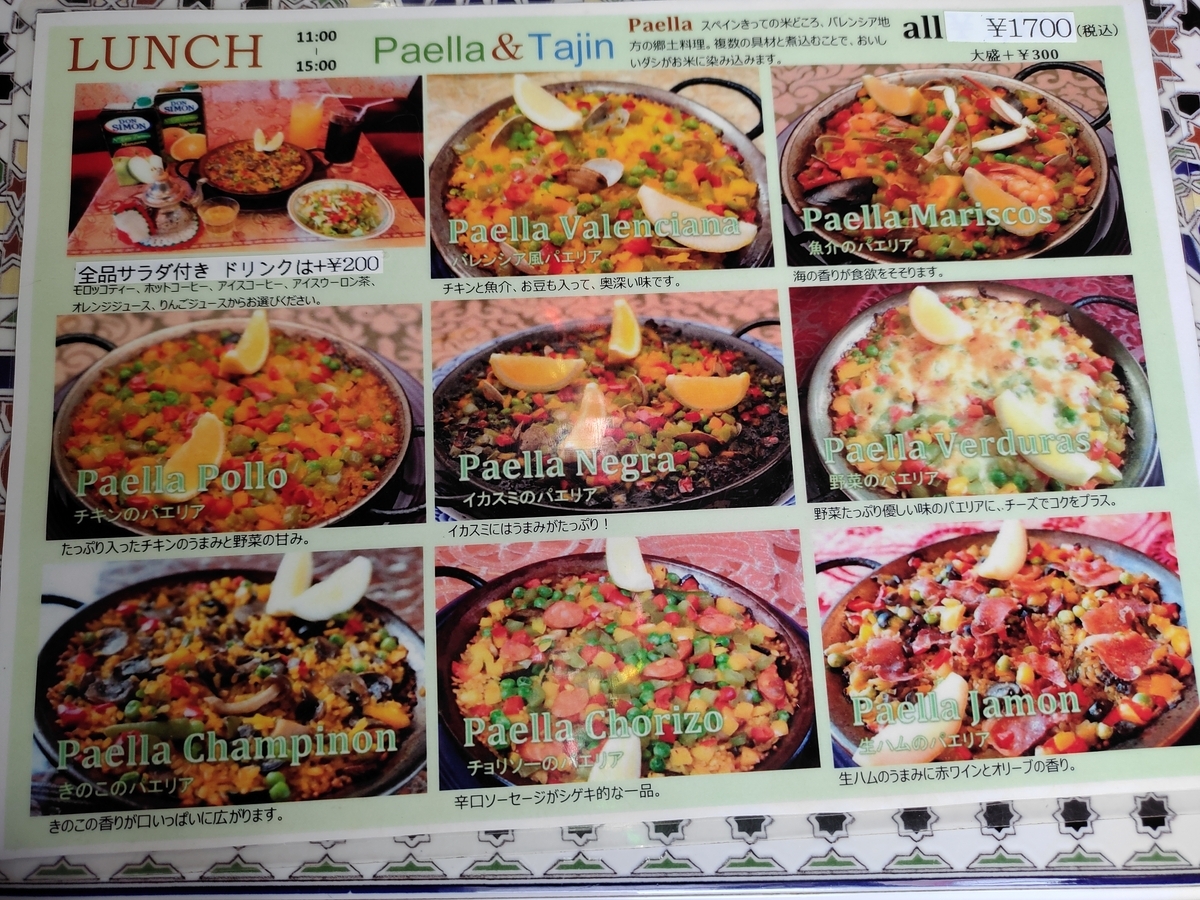
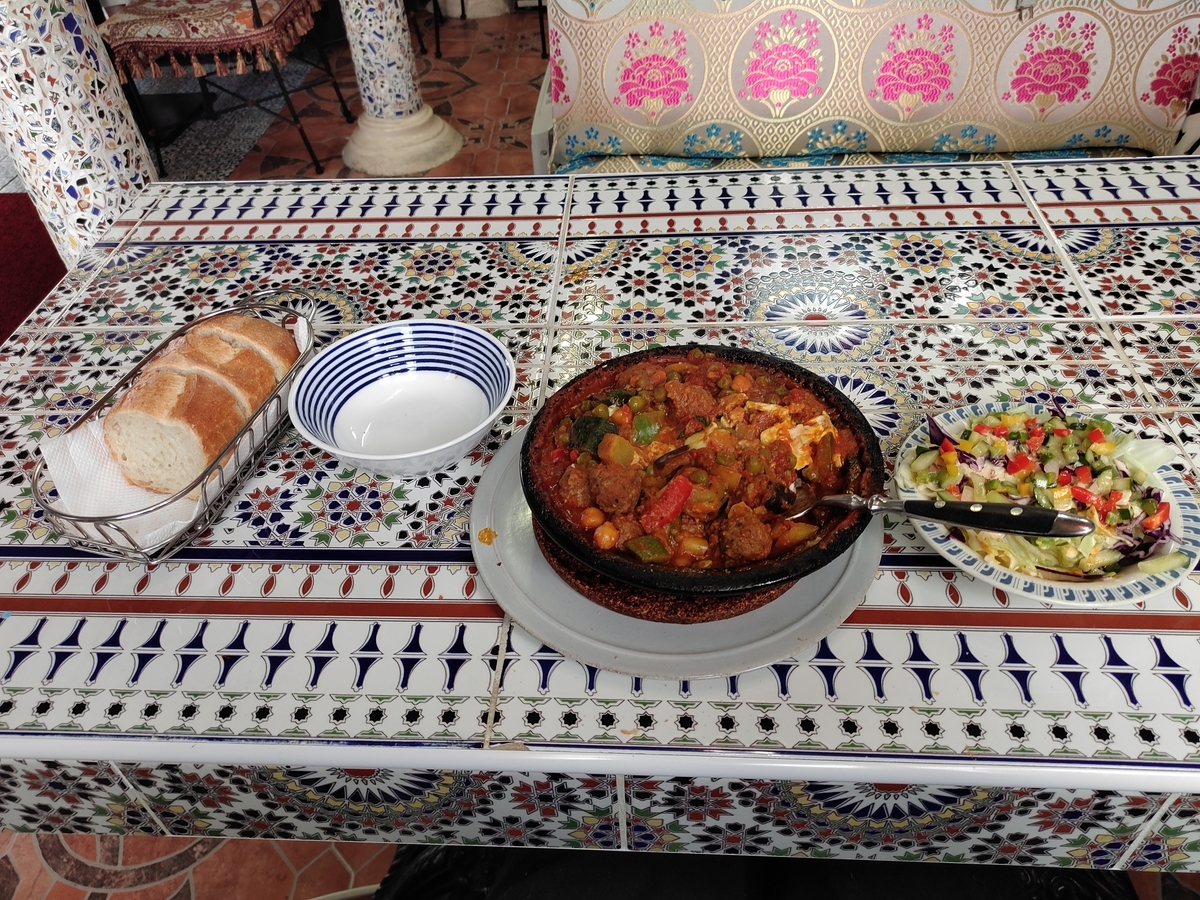
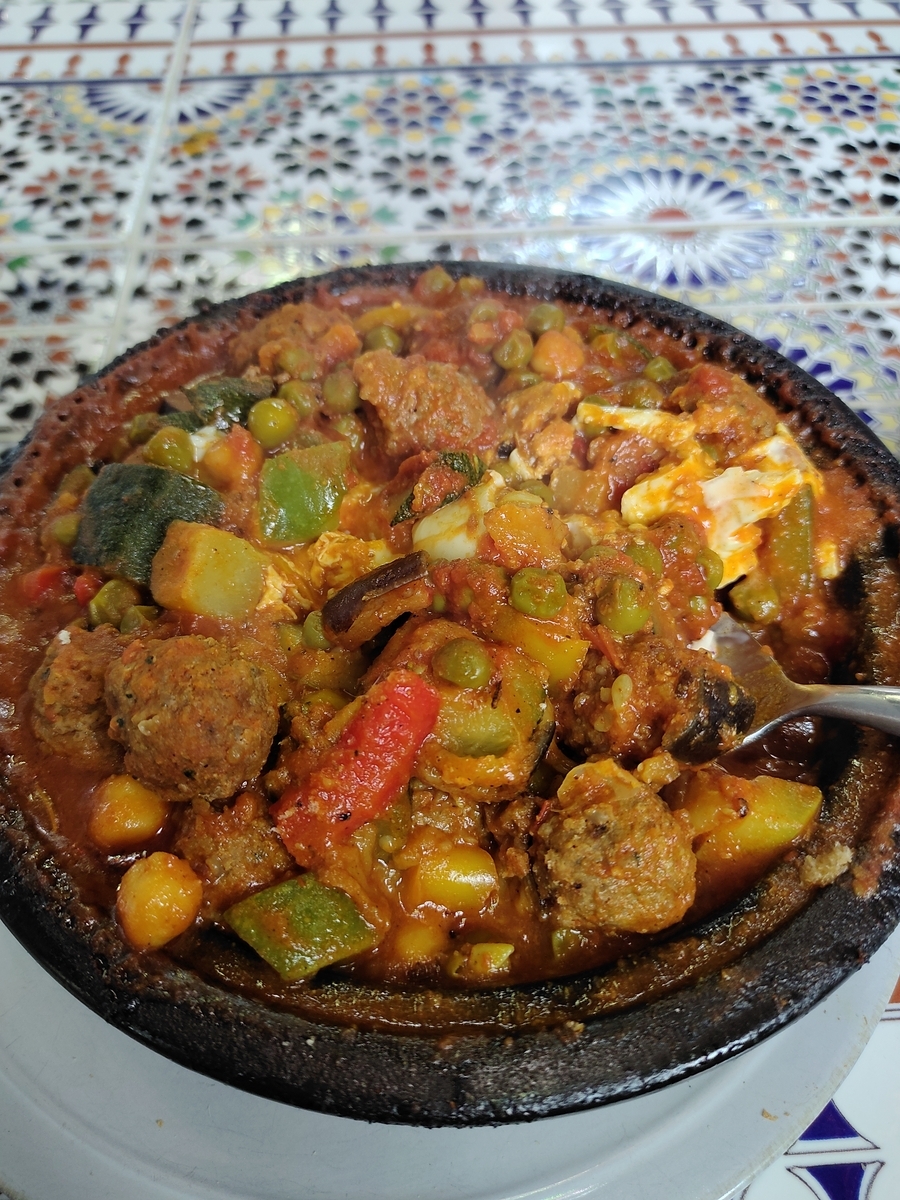
江古田でモロッコ料理でタジン鍋を食べてきた アランダルース (ALANDALUS)
6日間で-4kg アマチュアキックボクシングのゆるい減量方法
アマチュアキックボクシングの場合、検量後1,2時間ぐらいで試合ってパターンが多いかと思います。
そうなってくると通常の格闘家の減量方法だと当日リカバリーが間に合いません。
前日計量の格闘家の減量方法より当日計量のパワーリフティングの減量方法がかなり参考になるはず。
海外のいろんなパワーリフターの減量を参考にやってみました。
真似して健康に被害があっても責任とれませんので、自己責任でお願いします。
かなりゆるい減量となっております。アイスめっちゃ食べたし。
とあるアマチュアキックボクシングの試合に65kgで出場した時の減量記録となります。
試合6日前
朝起きてトイレ済ました後に体重計乗ってみる
68.6kg
試合は65kgなので3.6kgオーバー。
ウォーターローディング開始。
目標は8L。
また塩分は5g以内の摂取としました。
糖質は100gまででしたら、アイスとかチョコとか食べてOKにしました。
寝る前に体重を図ったら68.1kgとなっていました。
水はこの日は9L飲んでいました。
試合5日前
寝起きでトイレいって
66.6kg
予想以上に落ちていたので、糖質は気にせずとることにしました。
塩分は5g以内で引き続き水は8l目標で飲みます。
水飲むのが辛くなったらカラオケで歌って飲むを繰り返していました。
試合4日前
朝起きてトイレ済まして
66.8kg
ウォーターローディング+塩抜きだけで
今回落ちそう。
水8Lと塩5g以下を引き続き続ける。
試合3日前
朝起きてトイレいって
66.3kg
ここから塩分摂取量を3gにしてみる。
夕飯は流動食(アイス)へ変更。
水は変わらず8L飲みます。
試合2日前
ここらへんから体調的にフラフラしてくる。
起きて体重は
66kg
あと1kgだけなんで結構余裕。
水分は飲みたいときに飲むスタイルへ変更。
塩分1gと夕飯は流動食(アイス)で過ごす。
昼飯はパックのご飯に牛肉+マヨネーズ(マヨネーズは塩分が少ないからかけ放題)
試合1日前
朝起きて
65.2kg
塩抜きの効果がすごい出てる。
特に無理せず過ごす。
水は2L飲みました。
てかウォーターローディングしすぎて飲みたいと思わない。
夕飯は変わらず流動食(アイス)で過ごす。
塩分は1g以下にしました。たぶん0.5gぐらい。
計量日
朝起きて
64.4kg
-600gで朝を迎えることができました。
サウナや風呂で水抜きをせずに
68.6kg-64.4kg=4.2kg落とすことができました。
感想
普段サウナで2kg落とす減量をしていましたが
塩抜きだけ減量のほうが遥かに精神的に楽でした。
サウナで水抜きすると計量前までが喉渇きすぎてマジで辛いですが
今回は喉渇く感じはありませんでしたし、塩分とらなければ
アイス食べ放題でしたので楽でした。
次回は糖質もカットしてどこまで落とせるかやってみたいと思います。
Pythonで対象フォルダ内のファイル名を取得する
よく仕事でフォルダ内にあるファイル名を一個づつコピーして
メールで送るっていう謎作業がありまして
これPythonで全部取得できないかな?と思いやってみました。
対象のフォルダ内のファイル一覧取得の方法となります。
ついでに一覧をメモ帳に書き込んで保存までします。
全体コード
import glob2
import os

#ファイル名が欲しいフォルダを入力
files=input('フォルダパス:')

#glob関数でファイル名一覧取得
files_names=files+'/*'

files_names_l =glob2.glob(files_names)

#ファイル名だけに変形する

file_l=[]

for file in files_names_l:
	file_l.append(os.path.basename(file))

#改行して見やすくする
file_l_n="\n".join(file_l)

#ついでにテキストファイルに作成

export_text = files+"/test.txt"
with open(export_text, mode='w') as f:
	f.write(file_l_n)
解説
使用モジュール
モジュールはこの二つだけです。
osはデフォルトで入ってたはずですので、
pip install glob2 でインストールして使いましょう。
input関数でファイル名のフォルダを指定
#ファイル名が欲しいフォルダを入力
files=input('フォルダパス:')
表示としてはこんな感じ
フォルダパス:C:\pyworks←私が入力したパスになります。
取得するファイル名を指定
input関数で指定したパス内のファイル名を取得していきます。
#取得するファイル名を指定
files_names=files+'/*'
'/*'の部分の*でパス内のすべてファイル名を取得してきます。
ここを↓のように記述すると
#指定したパス内のテキストファイル名だけ取得
files_names=files+'/<strong>*.txt</strong>'
#指定したパス内のpdfファイル名だけ取得
files_names=files+'/<strong>*.pdf'</strong>
正規表現ってやつらしいです。
glob関数でファイル名一覧取得
ここでglob関数使っていきます。
ちなみにglob2とglobっていうモジュールありますが
何が変わったのか謎です。
超サイヤ人2のほうが超サイヤ人より強いから理論でglob2使ってます。
files_names_l =glob2.glob(files_names)
ここで取得した一覧だとこんなリストになってます。
["C:\Downloads\test.py","C:\Downloads\test1.py","C:\Downloads\test2.py"]
いや~見にくいんで、次でこれを分けていきます。
os.path.basenameでパスとファイル名部分をわける
file_l=[]

for file in files_names_l:
	file_l.append(os.path.basename(file))
os.path.basenameを使うことでパスとファイル名を分けることができます。
join関数で改行する
#改行して見やすくする
file_l_n="\n".join(file_l)
この時点で試しにprintしてみると下のようになるはずです。
test.py
test1.py
test2.py
せっかく出力したんでテキストファイルにしていきましょう。
export_text = files+"/test.txt"
with open(export_text, mode='w') as f:
	f.write(file_l_n)
保存先は最初に指定したパスにしています。
以上となります。
ありがとうございました。
お米ともち麦のカロリー計算
【Python】Office 365 の URL と IP アドレスの範囲からIPv4アドレスだけ抽出する
M365ではIPアドレスの範囲が毎月変更があって(IPv4アドレスは半年に一回ぐらい更新ある気がする)
変更があるたびにNW機器でルーティングの追加や削除が必要となります。
職場でIPv4のアドレスだけ抽出してほしいってなったのでPythonのスクレイピングで作ってみました。
全体コード
import datetime
import re
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.chrome import service as fs

CHROMEDRIVER = "C:\chormeドライバーおいてる場所指定"

# ドライバー
chrome_service = fs.Service(executable_path=CHROMEDRIVER)
browser = webdriver.Chrome(service=chrome_service)

#o365のページ
browser.get('https://docs.microsoft.com/ja-jp/microsoft-365/enterprise/urls-and-ip-address-ranges?view=o365-worldwide')


#IPアドレスの所だけ抽出

elems = browser.find_elements(By.TAG_NAME,'code')

#.textでテキストデータを抽出

values = []

for elem in elems:
    values.append(elem.text)


#抽出結果を','で連結

values_join=','.join(values)

#joinで連結した後にsplit(",")で分割
values_split=values_join.split(",")

#IPv4とそれ以外に抽出したデータをわける

values_alpha=[]
values_ipv4=[]

for i in values_split:
	alpha=re.findall('[a-z]+',i)
	if alpha:
		values_alpha.append(i)

	elif ':' not in i:

		values_ipv4.append(i)

values_new=[]

for i in values_ipv4:
	if ' ' in i:
		space=i.replace(' ','')
		values_new.append(space)
	else:
		values_new.append(i)

set_values=set(values_new)

#ファイル名用に日付取得

heute=str(datetime.date.today())

filename='C:\保存先'+heute+'.txt'


#txt書き出し

with open(filename, 'wt') as f:
	for ele in set_values:
		f.write(ele+'\n')
解説
使用するモジュール
import datetime
import re
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.chrome import service as fs
seleniumを使ってwebスクレイピングするのでググったら↑があれば大丈夫そう。
あと正規表現と日付を使うのでreとdatetimeをimportしています。
choromedriverを指定、URLを指定する
CHROMEDRIVER = "C:\chormeドライバーおいてる場所指定"

# ドライバー
chrome_service = fs.Service(executable_path=CHROMEDRIVER)
browser = webdriver.Chrome(service=chrome_service)

#o365のページ
browser.get('https://docs.microsoft.com/ja-jp/microsoft-365/enterprise/urls-and-ip-address-ranges?view=o365-worldwide')
"C:\chormeドライバーおいてる場所指定" だけchromedriverを保存したパスを指定してください。
o365のホームページからアドレス情報だけ抽出する
#IPアドレスの所だけ抽出

elems = browser.find_elements(By.TAG_NAME,'code')

#.textでテキストデータを抽出

values = []

for elem in elems:
    values.append(elem.text)
valuesにアドレス情報を抽出しました。
このままだと.comとかIPv6とIPv4が混じった状態なので次でデータを整えます。
一つのリスト内に複数IPアドレスが入ってるのでいったん一つにする
#抽出結果を','で連結

values_join=','.join(values)

#joinで連結した後にsplit(",")で分割
values_split=values_join.split(",")
これでリスト一つに1アドレスになりました。
IPv4とそれ以外に抽出データをわける
#IPv4とそれ以外に抽出したデータをわける

values_alpha=[]
values_ipv4=[]

for i in values_split:
	alpha=re.findall('[a-z]+',i)
	if alpha:
		values_alpha.append(i)

	elif ':' not in i:

		values_ipv4.append(i)
アルファベットが入ってるやつはvalues_alphaに格納して
残りでv6表記の【:】が入ってないやつ(すなわちIPv4アドレス)だけをvalues.ipv4へ格納
謎のスペースが入ってるので消す
values_new=[]

for i in values_ipv4:
	if ' ' in i:
		space=i.replace(' ','')
		values_new.append(space)
	else:
		values_new.append(i)

set_values=set(values_new)
なんかprintで見てみたらスペースが入ってたり入ってなかったりなんで
replaceで削除。あと重複してるアドレスもあったのでset()で削除しています。
テキストファイルに保存する
#ファイル名用に日付取得

heute=str(datetime.date.today())

filename='C:\保存先'+heute+'.txt'


#txt書き出し

with open(filename, 'wt') as f:
	for ele in set_values:
		f.write(ele+'\n')
ファイル名をdatetimeで取得した日にしています。
filename='C:\保存先'+heute+'.txt'
あとはwith構文でテキストファイルで出力で完了!!
pythonで複数のテキストファイルから欲しい部分だけ抽出する方法
Pythonで複数テキストファイル内の任意の文字列を含む行を抽出する方法のメモ
もっと効率のいい書き方が100%存在します、絶対。
今の実力がこれってことです。
全体コード
import glob


#取得したいテキストファイルのパスを指定
files='C:/テキストファイルが置いてある場所のパス'


#テキストファイルのパス一覧取得
file_name_edit=files+'/*.txt'
files =glob.glob(file_name_edit)

#テキストファイルが何個あるか確認(あとでfor文回すときに使う)
len_flies=len(files)


#抽出する関数作る
def file_edit(path):
	path_new='C:/新しく作るテキストファイルの名前'

	with open(path,"r") as f:
		lines = f.readlines()
		lines_strip = [line.strip() for line in lines]


      #抽出する文字の行数を調べる
		list_rownum = [i for i,lines_s in enumerate(lines_strip) if '抽出する部分' in lines_s]
		int_list_rownum=''

     #手に入れた行を読み取れるように変換
		for i in list_rownum:
			int_list_rownum=i


   #抽出する場所を行指定で読み込む
	with open(path) as f:
		lines01 = f.readlines()[int_list_rownum]

   #新しいテキストファイルに書き込む
	for i in lines01:
		with open(path_new, mode='a') as f:
			f.write(i)

#for文で↑作った関数を回す
for i in range(0,len_flies):
	file_edit(files[i])
解説
それでは解説していきます。
まずglob.glob()で対象パスにあるテキストファイルを取得する
import glob
globをインポート
#取得したいテキストファイルのパスを指定
files='C:/テキストファイルが置いてある場所のパス'

#テキストファイルのパス一覧取得
file_name_edit=files+'/*.txt'
files =glob.glob(file_name_edit)

#テキストファイルが何個あるか確認(あとでfor文回すときに使う)
len_flies=len(files)
正規表現ってやつ→*.txtとすることで対象のパスにあるすべてのテキストファイル一覧を取得できる。
関数作成
#抽出する関数作る
def file_edit(path):
	path_new='C:/新しく作るテキストファイルの名前'

	with open(path,"r") as f:
		lines = f.readlines()
		lines_strip = [line.strip() for line in lines]


      #抽出する文字の行数を調べる
		list_rownum = [i for i,lines_s in enumerate(lines_strip) if '抽出する部分' in lines_s]
		int_list_rownum=''

     #手に入れた行を読み取れるように変換
		for i in list_rownum:
			int_list_rownum=i


   #抽出する場所を行指定で読み込む
	with open(path) as f:
		lines01 = f.readlines()[int_list_rownum]

   #新しいテキストファイルに書き込む
	for i in lines01:
		with open(path_new, mode='a') as f:
			f.write(i)
ここを実際に作成するファイル名にしてください。
def file_edit(path):
	path_new='C:/新しく作るテキストファイルの名前'
list_rownum = [i for i,lines_s in enumerate(lines_strip) if '抽出する部分' in lines_s]
最後は自作関数を回しておしまい
   #新しいテキストファイルに書き込む
	for i in lines01:
		with open(path_new, mode='a') as f:
			f.write(i)
こんな感じです。
